Die meisten Unternehmen und Organisationen haben in den vergangenen Jahren viel Zeit und Geld in ihre Websites investiert. Sie haben Dienstleistungen beschrieben, Produkte erfasst, Fachwissen veröffentlicht und Informationen für Kunden, Mitglieder oder Geschäftspartner aufbereitet. Mit jeder neuen Seite ist ein Teil des Unternehmenswissens bzw. der Expertise ins Internet gelangt. Während sich die Gestaltung und die technischen Möglichkeiten von Websites laufend weiterentwickelt haben, ist ein Grundprinzip weitgehend immer gleich geblieben: Informationen werden in erster Linie für die Darstellung auf den einzelnen Webseiten aufbereitet. Mehr nicht.
Mit dem zunehmenden Einsatz künstlicher Intelligenz und der Vernetzung digitaler Dienstleistungen verändert sich diese Ausgangslage. Unternehmenswissen wird künftig nicht nur von Menschen gelesen, sondern vermehrt auch von Anwendungen verarbeitet, zwischen Systemen ausgetauscht und von intelligenten Assistenten genutzt. Damit stellt sich eine Frage, die für die langfristige Entwicklung der digitalen Unternehmenspräsenz entscheidend wird: Weshalb sollten wertvolle Informationen ausschliesslich innerhalb einer Website funktionieren?
Website als Aufbewahrungsort des Unternehmenswissens
Eine typische Unternehmenswebsite besteht aus einer Vielzahl von Seiten mit Texten, Bildern, Dokumenten und Formularen. Wer eine Dienstleistung sucht, besucht die entsprechende Unterseite, liest die Beschreibung und nimmt bei Interesse Kontakt auf. Bei einem Verband finden Mitglieder Informationen zu Veranstaltungen, Beratungsangeboten und Publikationen. Ein Tourismusportal stellt Unterkünfte, Ausflugsziele, Regionen und Aktivitäten vor. Diese Informationen sind häufig über Jahre hinweg entstanden und bilden zusammen einen beachtlichen Wissensbestand. Im Alltag wird jedoch selten zwischen dem eigentlichen Unternehmenswissen und seiner Darstellung auf einer Website unterschieden. Beides ist eng miteinander verbunden, sodass Informationen teilweise nur im Zusammenhang mit der jeweiligen Webseite gepflegt und verwendet werden können.
Diese Verbindung erscheint zunächst selbstverständlich, hat aber langfristige Nachteile. Informationen über eine Dienstleistung können beispielsweise gleichzeitig auf der Website, in einer Broschüre, in einem Kundenportal und in einem internen Dokument vorkommen. Ändern sich Preise, Öffnungszeiten oder Zuständigkeiten, müssen möglicherweise mehrere Stellen angepasst werden. Je grösser eine Organisation wird und je mehr digitale Anwendungen sie einsetzt, desto schwieriger wird es, alle Informationen aktuell und widerspruchsfrei zu halten. Das Problem liegt dabei nicht zwingend in der verwendeten Technologie, sondern häufig in der fehlenden Trennung zwischen dem Wissen selbst und den verschiedenen Orten, an denen dieses Wissen veröffentlicht wird.
Dass Datenqualität weit mehr umfasst als die blosse Richtigkeit einer Angabe, ist wissenschaftlich seit Langem untersucht. Bereits 1996 zeigten Richard Wang und Diane Strong in einer vielbeachteten Studie, dass Informationen aus Sicht ihrer Nutzer nicht nur korrekt, sondern auch verständlich, relevant, zugänglich und für den jeweiligen Zweck geeignet sein müssen. Spätere Arbeiten zur Datenverwaltung beschäftigen sich mit der Frage, wie Unternehmen Zuständigkeiten, Qualitätsstandards und Entscheidungsbefugnisse für ihre Informationen festlegen können. [1, 2] Diese Erkenntnisse sind heute besonders aktuell, weil digitale Informationen zunehmend nicht mehr ausschliesslich von Menschen interpretiert werden. Wo früher eine unklare Beschreibung durch eine telefonische Rückfrage ergänzt werden konnte, benötigen automatisierte Systeme eindeutige Angaben und nachvollziehbare Zusammenhänge.
Hinzu kommt ein verändertes Nutzungsverhalten. Laut einer Erhebung des Bundesamtes für Statistik hatten im Frühjahr 2025 bereits 43 Prozent der Schweizer Bevölkerung zwischen 15 und 88 Jahren generative KI mindestens einmal genutzt. Diese Zahl sagt noch nichts darüber aus, wie viele Menschen KI für konkrete Kaufentscheidungen einsetzen oder ihre Aufgaben bereits von autonomen Agenten erledigen lassen. Sie zeigt jedoch, wie rasch sich eine zusätzliche Form der Informationsnutzung etabliert. [8] Menschen müssen Informationen nicht mehr zwingend selbst auf verschiedenen Websites zusammensuchen, sondern können sich Zusammenhänge erklären, Angebote gegenüberstellen oder umfangreiche Dokumente zusammenfassen lassen. Für Unternehmen bedeutet dies, dass ihre Informationen künftig in unterschiedlichen Nutzungssituationen verfügbar und verständlich sein sollten, auch wenn die eigene Website weiterhin ein wichtiger Zugang bleibt.
Aus einzelnen Inhalten wird ein zusammenhängendes Informationssystem
Der entscheidende Schritt besteht darin, Unternehmensinformationen nicht mehr ausschliesslich als Bestandteile einzelner Webseiten zu betrachten, sondern als eigenständige, miteinander verknüpfte Informationen. Eine Veranstaltung ist dann beispielsweise nicht einfach ein Text mit einem Datum und einem Bild, sondern ein eindeutig beschriebenes Angebot mit einem Veranstalter, einem Ort, einem Zeitpunkt, einer Zielgruppe und möglicherweise einer Anmeldemöglichkeit. Eine Dienstleistung besitzt bestimmte Eigenschaften, ist an einem oder mehreren Standorten verfügbar und wird von einer klar bezeichneten Organisation angeboten. Diese Informationen lassen sich weiterhin auf einer Website darstellen. Sie können aber ebenso für andere Anwendungen verwendet werden, ohne dass sie dafür erneut erfasst oder aus einem bestehenden Webseitentext herausgelöst werden müssen.
Wie gross der Unterschied ist, zeigt sich am Beispiel eines Schweizer Tourismusportals. Eine klassische Website führt Besucherinnen und Besucher über Länder, Regionen, Ortschaften und einzelne Angebote zu den gewünschten Informationen. Das funktioniert für Menschen, die sich durch die Navigation bewegen und Angebote vergleichen möchten. Wird derselbe Informationsbestand jedoch als zusammenhängendes Datenmodell aufgebaut, können die Beziehungen zwischen diesen Informationen unabhängig von der Navigation genutzt werden. Ein Hotel befindet sich in einer bestimmten Ortschaft, gehört zu einer touristischen Region, besitzt bestimmte Ausstattungsmerkmale und liegt in der Nähe verschiedener Sehenswürdigkeiten. Ein Golfplatz kann mehreren Hotels zugeordnet sein, eine Veranstaltung findet an einem bestimmten Ort statt und ein Ausflugsziel ist während einer bestimmten Jahreszeit zugänglich. Aus diesen Beziehungen entstehen Möglichkeiten für Suchfunktionen, Reiseplaner, personalisierte Angebote und künftig auch für KI-Assistenten, die mehrere Anforderungen miteinander kombinieren sollen.
Die Grundlagen dafür sind älter als die gegenwärtige Entwicklung generativer KI. Bereits 2009 beschrieben Christian Bizer, Tom Heath und Tim Berners-Lee mit dem Konzept der *Linked Data*, wie Informationen im Internet nicht nur als Dokumente veröffentlicht, sondern anhand eindeutiger Identifikatoren und definierter Beziehungen miteinander verknüpft werden können. [3] Die Forschung zu sogenannten *Knowledge Graphs* hat diesen Ansatz weiterentwickelt. Solche Wissensgraphen beschreiben nicht nur einzelne Informationen, sondern auch deren Zusammenhänge und ermöglichen damit eine differenziertere Nutzung umfangreicher Wissensbestände. Die wissenschaftlichen Arbeiten von Natasha Noy und ihren Mitautoren sowie von Aidan Hogan und seinem Forschungsteam zeigen, dass entsprechende Konzepte längst in grossen Informationssystemen eingesetzt werden. [4, 5] Für eine kleinere Organisation bedeutet dies allerdings nicht, dass sie eine eigene Graphdatenbank betreiben muss. Entscheidend ist zunächst, dass Informationen klar unterscheidbar sind, über dauerhafte Identifikatoren verfügen und sinnvoll miteinander in Beziehung gesetzt werden können.
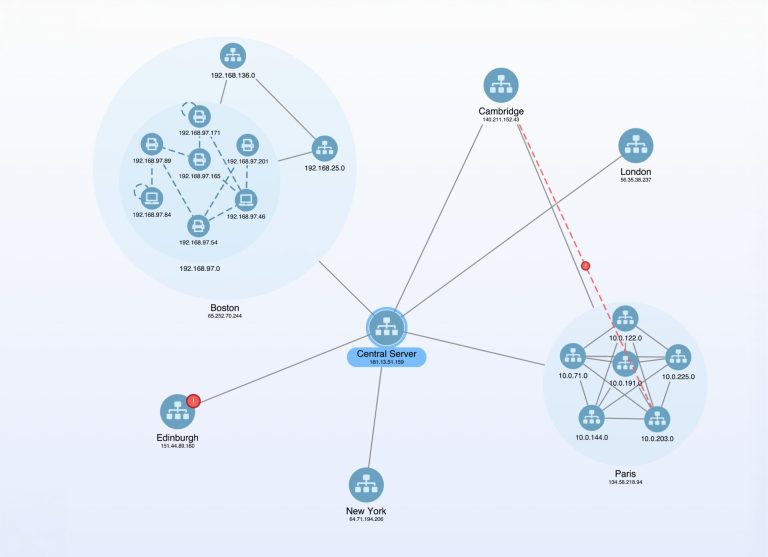
Abbildung: Graph (Quelle: Cambridge Intelligence)
Ein weiteres wichtiges Prinzip stammt aus der wissenschaftlichen Datenverwaltung. Die 2016 veröffentlichten FAIR-Prinzipien beschreiben, dass Daten auffindbar, zugänglich, interoperabel und wiederverwendbar sein sollten. Das Besondere daran ist, dass diese Anforderungen ausdrücklich auch die maschinelle Verarbeitung berücksichtigen. [6] Übertragen auf die Unternehmenswelt bedeutet dies, dass Informationen so organisiert werden sollten, dass unterschiedliche Anwendungen sie zuverlässig nutzen können. Die Zugänglichkeit ist dabei nicht mit einer uneingeschränkten Veröffentlichung gleichzusetzen. Ein Unternehmen kann seine öffentlichen Dienstleistungen frei zugänglich beschreiben und gleichzeitig interne Geschäftsdaten, Mitgliederinformationen oder persönliche Angaben schützen. Entscheidend ist die kontrollierte Nutzbarkeit der Daten, nicht deren vollständige Offenlegung.
In der Praxis entsteht so etwas, das man als zentrale Informationsgrundlage bezeichnen kann. Dabei müssen nicht sämtliche Daten physisch in einer einzigen Datenbank gespeichert werden. Gerade grössere Unternehmen besitzen bereits spezialisierte Systeme für Produkte, Kunden, Mitglieder, Buchungen oder Veranstaltungen. Eine sinnvolle Architektur kann diese bestehenden Datenquellen miteinander verbinden und über klar definierte Schnittstellen zugänglich machen. Wichtig ist, dass für jede Information feststeht, welches System die verbindliche Quelle ist, wer für ihre Pflege verantwortlich ist und wie andere Anwendungen darauf zugreifen dürfen. Internationale Empfehlungen des World Wide Web Consortiums, darunter die 2017 veröffentlichten «Data on the Web Best Practices», beschäftigen sich genau mit solchen Anforderungen an Metadaten, dauerhafte Identifikatoren, Datenqualität, Wiederverwendbarkeit und Schnittstellen. [9]
Eine von mehreren möglichen Oberflächen: Die Website der nahen Zukunft
Eine wesentliche Konsequenz dieser Entwicklung betrifft den Aufbau von Websites selbst. Während Inhalte und ihre Darstellung in klassischen Systemen häufig eng miteinander verbunden sind, lassen sich beide Bereiche technisch zunehmend unabhängig voneinander organisieren. Die Website übernimmt dann vor allem die Aufgabe, Informationen für Menschen übersichtlich, verständlich und ansprechend darzustellen. Dahinter befindet sich eine eigenständige Ebene, in der Inhalte, Daten und gegebenenfalls Geschäftsprozesse verwaltet werden. Dieselben Informationen können über geeignete Schnittstellen auch einer mobilen Anwendung, einem Mitgliederportal, einem externen Partner oder einem unternehmenseigenen KI-Assistenten zur Verfügung stehen.
In der technischen Fachwelt wird bei einer solchen Trennung häufig von einer *Headless*- oder *Decoupled*-Architektur gesprochen. Für die Geschäftsführung ist jedoch weniger der Begriff als vielmehr der wirtschaftliche Nutzen entscheidend. Ein Unternehmen kann seine sichtbare Website erneuern, neue digitale Dienstleistungen anbieten oder zusätzliche Kommunikationskanäle erschliessen, ohne deshalb zwangsläufig seine gesamte Informationsgrundlage ersetzen zu müssen. Ein Schweizer Verband könnte beispielsweise seine Fachpublikationen, Veranstaltungen und Beratungsangebote zentral pflegen und diese gleichzeitig auf seiner öffentlichen Website, in einem geschützten Mitgliederbereich und in einer internen Wissenssuche verwenden. Eine mehrsprachige Organisation könnte Inhalte und deren Übersetzungen gemeinsam verwalten, während unterschiedliche Benutzeroberflächen auf dieselben Informationen zugreifen. Damit wird die Website nicht unwichtiger, sondern unabhängiger von der technischen Verwaltung der Inhalte.
Diese Trennung lässt sich bereits heute mit etablierten Systemen umsetzen. WordPress stellt mit seiner REST-Schnittstelle Möglichkeiten bereit, Inhalte in anderen Anwendungen zu verwenden, während Drupal mit seiner Datenmodellierung und der JSON:API umfangreiche Funktionen zur strukturierten Bereitstellung von Informationen anbietet. [12, 13] Daraus folgt jedoch nicht, dass jede Unternehmenswebsite künftig vollständig entkoppelt aufgebaut werden sollte. Für viele kleinere Betriebe und Vereine kann ein gut gepflegtes, klassisches Content-Management-System weiterhin die wirtschaftlich sinnvollste Lösung sein. Die entscheidende Frage lautet vielmehr, ob die verwendete Lösung mit den Anforderungen wachsen kann und ob wertvolle Informationen auch dann erhalten und nutzbar bleiben, wenn sich die sichtbare Website oder einzelne technische Komponenten verändern.
Die zunehmende Bedeutung der künstlichen Intelligenz verstärkt diesen Gedanken. Bei der sogenannten *Retrieval-Augmented Generation*, kurz RAG, greifen Sprachmodelle bei der Beantwortung von Fragen auf zusätzliche Informationsquellen zurück. Diese Methode wurde unter anderem 2020 von Patrick Lewis und seinen Mitautoren wissenschaftlich untersucht. [7] Für Unternehmen eröffnet sie die Möglichkeit, eigene Wissensbestände als Grundlage für KI-gestützte Auskunftssysteme zu verwenden. Eine Organisation könnte beispielsweise einen Assistenten anbieten, der Fragen zu ihren Dienstleistungen, Reglementen oder Publikationen beantwortet und die verwendeten Quellen ausweist. Voraussetzung dafür sind nicht nur geeignete technische Schnittstellen, sondern vor allem aktuelle, gut strukturierte und verlässliche Informationen. Eine KI kann bei der Suche und Aufbereitung von Wissen helfen; sie ersetzt jedoch weder die fachliche Verantwortung für die Inhalte noch die Notwendigkeit, deren Richtigkeit regelmässig zu überprüfen.
Es wäre zudem falsch, aus dieser Entwicklung abzuleiten, dass strukturierte Unternehmensdaten automatisch zu einer besseren Platzierung in KI-generierten Suchergebnissen führen. Google hält in seinen offiziellen Empfehlungen ausdrücklich fest, dass für die Berücksichtigung in seinen KI-Suchfunktionen keine speziellen zusätzlichen Markierungen erforderlich sind und die bisherigen Grundlagen einer guten Suchmaschinenoptimierung weiterhin gelten. [10] Strukturierte Daten, beispielsweise auf Basis von Schema.org, helfen dabei, Informationen über Unternehmen, Produkte, Dienstleistungen oder Veranstaltungen eindeutig zu beschreiben und unterstützen bestimmte Funktionen von Suchmaschinen und anderen Anwendungen. [11] Sie sind jedoch nur ein Bestandteil einer umfassenderen Informationsarchitektur. Eine maschinenlesbare Beschreibung macht aus einem unvollständigen oder veralteten Informationsbestand noch keine zuverlässige Datenquelle.
Was Sie als Unternehmen mit ihren digitalen Informationen tun sollten
Für Schweizer KMU, Verbände, Vereine und Stiftungen beginnt dieser Wandel deshalb nicht zwangsläufig mit einer neuen Website oder einer umfangreichen technischen Investition. Vielmehr lohnt es sich, die vorhandenen Informationen erstmals als zusammenhängenden Unternehmenswert zu betrachten. Welche Inhalte sind für Kunden, Mitglieder oder andere Anspruchsgruppen besonders wichtig? Wo werden sie heute erfasst und gepflegt? Welche Angaben sind mehrfach vorhanden, welche Beziehungen bestehen zwischen ihnen und welche Informationen könnten künftig auch ausserhalb der Website genutzt werden? Schon eine sorgfältige Bestandsaufnahme kann aufzeigen, wo Informationen doppelt verwaltet werden, Aktualisierungen unnötig aufwendig sind oder wertvolles Fachwissen in einzelnen Dokumenten verborgen bleibt.
Ein sinnvoller nächster Schritt besteht darin, besonders wichtige Informationen klar zu strukturieren und ihre Pflege verbindlich zu organisieren. Bei einem Verein können dies Mitgliederangebote, Veranstaltungen, Standorte und Publikationen sein, bei einem KMU Dienstleistungen, Produkte, Fachpersonen oder Referenzen. Grössere Portale benötigen zusätzlich häufig eine differenzierte Beschreibung ihrer Angebote und der Beziehungen zwischen verschiedenen Informationen. Dabei muss nicht alles gleichzeitig umgesetzt werden. Häufig ist es wirtschaftlich vernünftiger, mit denjenigen Datenbeständen zu beginnen, die heute bereits mehrfach verwendet werden oder einen hohen Pflegeaufwand verursachen. Erst danach lässt sich fundiert entscheiden, ob zusätzliche Schnittstellen, ein erweitertes Datenmodell oder eine stärker entkoppelte Systemarchitektur einen tatsächlichen Mehrwert bieten.
Ebenso wichtig ist die Frage, welche Informationen öffentlich zugänglich sein dürfen und welche geschützt bleiben müssen. Das Schweizer Datenschutzgesetz verlangt bei der Bearbeitung von Personendaten angemessene technische und organisatorische Massnahmen und berücksichtigt ausdrücklich den Datenschutz durch Technikgestaltung und datenschutzfreundliche Voreinstellungen. [14] Eine zukunftsfähige digitale Informationsarchitektur muss deshalb nicht möglichst viele Daten veröffentlichen, sondern deren Nutzung gezielt steuern können. Öffentliche Unternehmensinformationen, interne Dokumente und personenbezogene Daten benötigen unterschiedliche Berechtigungen und Schutzmechanismen. Gerade wenn künftig weitere Anwendungen und intelligente Agenten auf Unternehmenssysteme zugreifen, wird diese Unterscheidung zunehmend wichtig.
Der eigentliche Nutzen dieser Entwicklung liegt letztlich in einer veränderten Betrachtung digitaler Investitionen. Eine Website wird auch in Zukunft eine wichtige Aufgabe erfüllen: Sie vermittelt einen ersten Eindruck, schafft Vertrauen, präsentiert Leistungen und ermöglicht den direkten Kontakt mit einer Organisation. Ihre Gestaltung, Benutzerfreundlichkeit und technische Qualität bleiben deshalb wesentlich. Wenn das Wissen dahinter jedoch unabhängig von dieser Darstellung organisiert ist, lassen sich neue Anforderungen wesentlich flexibler erfüllen. Das Unternehmen muss nicht bei jeder technologischen Veränderung von vorne beginnen, sondern kann auf einer Informationsgrundlage aufbauen, die bereits vorhanden ist und gezielt weiterentwickelt werden kann.
**Die Website der Zukunft ist deshalb nicht einfach eine modernere Version der heutigen Website. Sie ist zunehmend die sichtbare Oberfläche einer digitalen Informationsgrundlage, die weit über den einzelnen Internetauftritt hinausreicht.** Für Unternehmen entsteht daraus die Chance, ihre vorhandenen Informationen nicht nur besser zu präsentieren, sondern langfristig sinnvoller zu nutzen. Der wichtigste Schritt besteht darin, Unternehmenswissen nicht länger ausschliesslich als Inhalt einzelner Webseiten zu verstehen, sondern als eigenständigen Wert, der unabhängig von seiner Darstellung gepflegt, verbunden und für unterschiedliche Anwendungen zugänglich gemacht werden kann.
—
*Dieser Beitrag ist Teil unserer Artikelserie «Websites im Wandel», in der wir aufzeigen, wie künstliche Intelligenz die Anforderungen an Unternehmenswebsites verändert und welche Entwicklungen für Unternehmen und Organisationen relevant werden.*
Quellen und weiterführende Literatur
**Wissenschaftliche Fachpublikationen**
1. Wang, R. Y. & Strong, D. M. (1996). *Beyond Accuracy: What Data Quality Means to Data Consumers*. Journal of Management Information Systems, 12(4), 5–33. [Fachpublikation](https://www.jmis-web.org/articles/1002)
2. Khatri, V. & Brown, C. V. (2010). *Designing Data Governance*. Communications of the ACM, 53(1), 148–152. https://doi.org/10.1145/1629175.1629210
3. Bizer, C., Heath, T. & Berners-Lee, T. (2009). *Linked Data – The Story So Far*. International Journal on Semantic Web and Information Systems, 5(3), 1–22. https://doi.org/10.4018/jswis.2009081901
4. Noy, N. et al. (2019). *Industry-scale Knowledge Graphs: Lessons and Challenges*. Communications of the ACM, 62(8), 36–43. [Google Research](https://research.google/pubs/industry-scale-knowledge-graphs-lessons-and-challenges/)
5. Hogan, A. et al. (2021). *Knowledge Graphs*. ACM Computing Surveys, 54(4), Article 71. https://doi.org/10.1145/3447772
6. Wilkinson, M. D. et al. (2016). *The FAIR Guiding Principles for Scientific Data Management and Stewardship*. Scientific Data, 3, 160018. https://doi.org/10.1038/sdata.2016.18
7. Lewis, P. et al. (2020). *Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks*. Advances in Neural Information Processing Systems, 33. [NeurIPS Proceedings](https://proceedings.neurips.cc/paper/2020/hash/6b493230-Abstract.html) **Öffentliche Institutionen, Standards und technische Praxisquellen**
8. Bundesamt für Statistik (2025). *Internetnutzung in den Schweizer Haushalten 2025*. Medienmitteilung vom 5. Dezember 2025. [Bundesamt für Statistik](https://statistik.admin.ch/de/asset/36304417)
9. World Wide Web Consortium (2017). *Data on the Web Best Practices*. W3C Recommendation. https://www.w3.org/TR/dwbp/
10. Google Search Central (2026). *AI Features and Your Website*. Offizielle Dokumentation zu KI-Funktionen in der Google-Suche. [Google Developers](https://developers.google.com/search/docs/appearance/ai-features)
11. Schema.org. *Schemas for Structured Data on the Internet*. https://schema.org/
12. WordPress.org. *REST API Handbook*. https://developer.wordpress.org/rest-api/
13. Drupal.org. *JSON:API Module – API Overview*. [Drupal-Dokumentation](https://www.drupal.org/docs/core-modules-and-themes/core-modules/jsonapi-module/api-overview)
14. Schweizerische Eidgenossenschaft. *Bundesgesetz über den Datenschutz (DSG)*, insbesondere Art. 7 und 8. [Fedlex](https://www.fedlex.admin.ch/eli/cc/2022/491/de)